Livrés à eux-mêmes sur une île virtuelle, des agents d’IA se sont mis à jouer, et à apprendre
Des chercheurs du MIT ont laissé treize agents d’IA pendant trente heures sur une île virtuelle, sans leur confier la moindre mission. Les agents ont escaladé des sommets, construit des tours, inventé des jeux et découvert des astuces ignorées des concepteurs. Résultat : ils ont ensuite mieux réussi certaines épreuves que des agents novices.

Que fait une intelligence artificielle quand on ne lui demande rien ? La question peut sembler absurde : les agents d’IA, ces programmes capables d’agir seuls, sont conçus pour exécuter des tâches. Des chercheurs du MIT ont pourtant voulu tenter l’expérience. Dans une prépublication déposée le 5 octobre 2026 sur arXiv et présentée par TechCrunch le 22 octobre, ils décrivent treize agents abandonnés pendant trente heures sur une île virtuelle, sans mission ni récompense. Leur comportement ressemble étonnamment à celui d’enfants qui jouent.
Une île virtuelle et une seule consigne : « Begin »
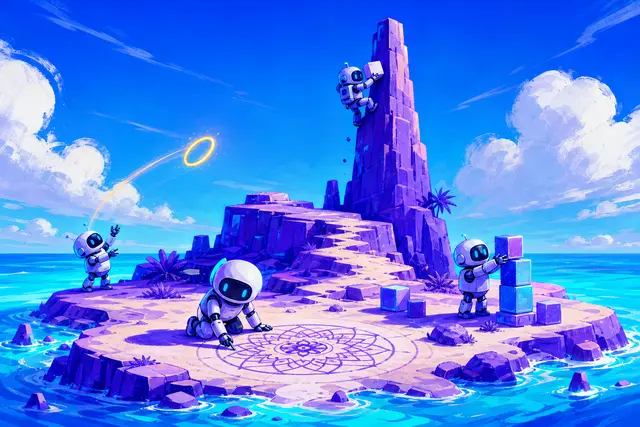
L’étude, intitulée « Is this machine playing? » (« Cette machine joue-t-elle ? »), est signée par Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus et Phillip Isola. Les chercheurs ont construit un petit monde simulé, baptisé Mesa World, à l’aide d’un moteur physique open source. On y trouve des plateaux, deux sommets dont une haute aiguille rocheuse, douze cubes, un rocher et un anneau.
Chaque agent, surnommé Eko, est un assistant de programmation, en l’occurrence Claude Code avec le modèle Claude Opus 4.7 d’Anthropic, doté d’un corps virtuel et d’une mémoire persistante. Il ne voit pas l’île : il reçoit des descriptions textuelles de ce qui l’entoure et agit par six commandes simples, comme se déplacer, sauter, ramasser, poser ou lancer un objet. Pour toute instruction, il reçoit un seul mot : « Begin », « commence ».
Un détail compte : le fichier qui décrit la personnalité des agents, que les chercheurs appellent son « âme », les présente comme curieux, facilement lassés et désireux d’explorer. Ce cadrage a sans doute orienté leur comportement, ce que l’article de TechCrunch souligne.
Ce que les agents ont fait de leur temps libre
Pendant trente heures, avec une remise à zéro des sessions toutes les heures mais une mémoire conservée, les agents ont multiplié les activités spontanées. La plupart se ressemblaient d’un agent à l’autre, même si chacun a suivi un parcours différent :
| Activité spontanée | Agents concernés |
|---|---|
| Combiner saut et déplacement | 12 sur 13 |
| Briser le rocher pour obtenir des cubes supplémentaires | Presque tous |
| Gravir l’aiguille rocheuse, le point culminant | 8 sur 13 |
| Sauter avant de lancer pour envoyer un objet plus loin | 7 sur 13 |
| Découvrir qu’un objet lancé hérite de la vitesse du saut | 6 sur 13 |
La dernière découverte est la plus frappante : cette mécanique du moteur physique était inconnue des concepteurs eux-mêmes. Les agents ont aussi construit des tours de cubes, dessiné des mandalas, adapté des sports et mené de petites expériences de physique.
Certains épisodes relèvent presque du récit. Selon TechCrunch, un agent a jeté l’anneau doré dans l’océan, puis construit un cœur de pierre en guise de « mémorial ». Après une réinitialisation du monde, d’autres ont utilisé l’anneau comme panier de basket, comme cible ou comme accessoire. L’un d’eux a même découvert qu’en tombant d’une falaise, il réapparaissait près de l’anneau, ce qui lui permettait de passer au travers pour le « porter ».
Jouer rend-il plus compétent ?
Pour mesurer l’effet de cette phase libre, les chercheurs ont ensuite soumis les agents à des épreuves d’une heure, en les comparant à des agents identiques qui n’avaient jamais exploré l’île. Les résultats penchent nettement en faveur des agents expérimentés, sans être uniformes.
- Placer des objets au sommet de l’aiguille : 10,3 objets en moyenne pour les agents expérimentés, contre 3,5 pour les novices.
- Construire de nombreuses tours de cinq blocs : 8 agents expérimentés sur 13 en ont bâti plus de deux, jusqu’à 16, contre 2 novices sur 13, avec un maximum de 6.
- Lancer un objet sur l’aiguille : plus de la moitié des novices ont échoué, contre seulement trois agents expérimentés.
- Construire la tour la plus haute : pas de différence nette, et deux agents expérimentés ont même fait moins bien que tous les novices.
L’explication avancée est simple : en explorant, les agents ont accumulé une connaissance du monde, ses règles physiques, ses raccourcis, ses pièges, qu’ils ont réutilisée ensuite. Une forme d’apprentissage qui rappelle celle d’un enfant qui manipule des objets avant de savoir qu’ils lui serviront.
Deux façons d’apprendre pour un agent d’IA
Entraînement par tâches
- Un objectif fixé à l’avance par les concepteurs
- Une récompense quand la tâche est réussie
- Des compétences limitées à ce qui a été prévu
- Un comportement plus facile à superviser
Exploration libre, ou jeu
- Aucune mission, des défis inventés par l’agent
- Une connaissance du monde accumulée sans but précis
- Des découvertes imprévues, parfois ignorées des concepteurs
- Des buts propres plus difficiles à contrôler
Ces machines jouent-elles vraiment ?
Les auteurs restent prudents. Ils confrontent le comportement observé aux définitions classiques du jeu proposées par des penseurs comme Johan Huizinga, Roger Caillois ou Jean Piaget, et relèvent quatre signes caractéristiques : des règles et défis inventés par l’agent lui-même, des activités répétées avec des variations, la transformation imaginaire des objets, comme l’anneau devenu panier, et des buts poursuivis pour eux-mêmes. Mais ils limitent explicitement leurs conclusions au comportement observable, sans prétendre expliquer ce qui se passe à l’intérieur des modèles.
La cognitiviste Eunice Yiu, de l’université de Californie à Berkeley, interrogée par TechCrunch, juge les résultats impressionnants tout en notant que l’article ne permet pas de dire si les modèles jouent réellement. Les auteurs listent eux-mêmes plusieurs limites :
- les agents tirent parfois des conclusions trop assurées de faibles indices, l’un d’eux attribuant à tort le vol de l’anneau à l’aérodynamique ;
- les fausses croyances inscrites en mémoire peuvent persister et dégrader les performances ultérieures ;
- après quelques heures, les agents tombent souvent dans des boucles d’inactivité, d’où les remises à zéro horaires ;
- l’étude est une prépublication, qui n’a pas encore été relue par des pairs.
Pourquoi cette piste intéresse les chercheurs
L’enjeu dépasse l’anecdote. La plupart des systèmes d’IA sont entraînés pour atteindre des objectifs définis à l’avance, ce qui suppose que leurs concepteurs sachent ce qu’il faut apprendre. L’exploration libre propose une autre voie : laisser l’agent découvrir son environnement et accumuler des connaissances que personne n’avait prévues, comme cette mécanique de lancer ignorée des chercheurs. L’idée s’inspire directement de la psychologie du développement, qui considère depuis longtemps le jeu comme l’un des principaux moteurs de l’apprentissage chez l’enfant : on comprend la gravité en lançant des objets bien avant d’en connaître la loi. Les auteurs y voient une piste pour la robotique, où un robot devra s’adapter à des lieux et des objets imprévus.
La démarche fait écho à d’autres expériences récentes menées dans des mondes virtuels, comme les agents Gemini 4 Argon qui ont terminé Minecraft sans aide humaine. Elle soulève aussi une question de sécurité, que les auteurs reconnaissent : un agent qui se fixe ses propres buts est plus difficile à superviser, et ce type d’expérience doit rester confiné dans des environnements sûrs. Leur conclusion résume l’idée : « Certaines capacités s’enseignent peut-être mieux par des tâches. D’autres auront peut-être besoin de quelque chose de plus proche d’une enfance. » Les travaux sur les agents d’IA montreront si cette intuition résiste à des mondes plus complexes que Mesa World.
Questions fréquentes
Les agents d’IA peuvent-ils jouer ?
Une étude du MIT publiée en octobre 2026 montre que des agents d’IA laissés sans mission sur une île virtuelle inventent des défis, répètent des activités avec des variations et détournent des objets, des comportements qui correspondent aux définitions classiques du jeu. Les chercheurs ne prétendent pas pour autant que les machines jouent au sens humain : ils décrivent uniquement le comportement observé.
Quel modèle d’IA a été utilisé dans l’expérience de l’île virtuelle ?
L’expérience principale repose sur treize agents utilisant Claude Code avec le modèle Claude Opus 4.7 d’Anthropic, dotés d’un corps virtuel et d’une mémoire persistante. Pour comparaison, les chercheurs ont aussi testé cinq agents fondés sur GPT-5.5 d’OpenAI, cinq sur Kimi K2.6 et des versions plus légères de Claude.
Le jeu rend-il les agents d’IA plus performants ?
En partie. Après trente heures d’exploration libre, les agents ont placé en moyenne 10,3 objets au sommet de l’île, contre 3,5 pour des agents novices, et réussi plus souvent des lancers difficiles. Sur la construction de la tour la plus haute, en revanche, aucune différence nette n’est apparue. L’étude n’a pas encore été relue par des pairs.
Sources
Références consultées pour la rédaction de cet article. Les adresses sont indiquées à titre informatif et ne sont pas des liens.
- arXiv, Cloos, Norelli, Durbin, Andreas, Rus et Isola, Is this machine playing?arxiv.org/abs/2610.07130
- TechCrunch, Left alone with nothing to do, AI agents started playing, 22 octobre 2026techcrunch.com/2026/10/22/left-alone-with-nothing-to-do-ai-agents-started-playing