Agents d’IA : Anthropic explique comment Claude apprend de ses erreurs en « rêvant »
Anthropic a publié le 6 novembre 2026 une étude sur la mémoire des agents d’IA. Notes prises en cours de tâche, wikis internes et phase de « rêve » pendant laquelle l’agent relit et corrige ses souvenirs : l’entreprise chiffre les gains et détaille les pièges. Un éclairage utile pour quiconque confie des tâches longues à un agent.

Un agent d’IA qui recommence chaque tâche sans se souvenir de la précédente refait les mêmes erreurs. Comment lui donner une mémoire fiable ? Le 6 novembre 2026, Anthropic a publié une étude détaillée, signée par Lance Martin, sur les composantes de la mémoire des agents. L’entreprise y décrit comment ses modèles Claude conservent des connaissances d’une session à l’autre, chiffre les gains obtenus et détaille les erreurs à éviter.
De quoi parle-t-on quand on parle de mémoire d’un agent ?
Un agent d’IA est un programme fondé sur un modèle de langage qui enchaîne des actions pour accomplir une tâche. Par défaut, chaque nouvelle session repart de zéro. Anthropic définit la mémoire d’un agent comme les connaissances qu’il tire de son expérience et qu’il conserve entre les sessions, sous forme de texte qu’il peut relire plus tard.
Cette définition exclut volontairement deux mécanismes : la modification du modèle lui-même par un nouvel entraînement, et le simple contexte d’une conversation en cours, qui disparaît à la fin de la session.
Une mémoire organisée en couches
Anthropic décrit une organisation en plusieurs niveaux, du plus détaillé au plus synthétique :
| Couche | Rôle |
|---|---|
| Historiques de sessions | Le journal complet de ce que l’agent a fait, consultable par recherche |
| Notes de mémoire | Ce que l’agent juge utile de retenir, écrit pendant la tâche |
| Représentations, comme des wikis | Des pages reliées entre elles qui servent de carte pour s’orienter |
| Contexte chargé à chaque session | Un petit ensemble de notes lu systématiquement au démarrage |
La couche supérieure doit rester courte, insiste l’étude : chaque note chargée à chaque session consomme des ressources, et une note erronée y contamine toutes les sessions suivantes. Les détails doivent être relégués aux niveaux inférieurs, avec des liens pour les retrouver. Dans Claude Code, l’outil de programmation d’Anthropic, la mémoire automatique ne charge d’ailleurs que les 200 premières lignes ou 25 Ko de son fichier principal, qui sert d’index.
Des gains nets sur les modèles récents
Pour mesurer l’effet de la mémoire, Anthropic a utilisé un test baptisé CL-Bench, dans lequel l’agent répond à des questions sur une base de données. Chaque question ouvre une nouvelle session, et un dossier de mémoire est le seul lien entre elles. Après chaque réponse, l’agent apprend la bonne solution et peut noter ce qu’il en retient.
| Modèle | Score sans mémoire | Score avec mémoire |
|---|---|---|
| Claude Opus 5.5 | 0,655 | 0,838 |
| Claude Sonnet 5.5 | 0,644 | 0,833 |
| Claude Opus 5 | 0,564 | 0,828 |
| Claude Opus 4.7 | 0,383 | 0,700 |
| Claude Sonnet 5 | 0,306 | 0,610 |
| Claude Sonnet 4.6 | 0,330 | 0,364 |
L’écart entre les générations tient à la façon de prendre des notes. Selon Anthropic, Sonnet 4.6 formulait des hypothèses sans les vérifier. Opus 5 est le premier de ces modèles à « boucler la boucle » : ses notes énoncent une règle, la manière dont il l’a établie et les pièges à éviter. Sonnet 5 relit sa mémoire avant de répondre neuf fois sur dix sans qu’on le lui demande, contre moins d’une fois sur deux pour Sonnet 4.6.
Savoir ce qui mérite d’être retenu
Prendre des notes, c’est faire un pari : écrire une règle revient à prédire qu’elle servira de nouveau. Anthropic l’illustre avec le jeu vidéo Pokémon Rouge. Après environ 10 000 actions, l’ancien modèle Claude Sonnet 3.7 avait accumulé 413 fichiers répartis dans 225 dossiers, près d’un million de caractères, et n’avait gagné qu’un badge. Il passait son temps à mettre à jour des informations périmées. Un modèle plus récent s’est contenté d’une dizaine de fichiers, environ 43 000 caractères, et avait remporté quatre badges. Claude Opus 5.5, lui, a terminé le jeu en tenant à jour un petit dossier sur son objectif et ses prochaines étapes.
La leçon vaut aussi pour les consignes. Imposer à un modèle récent une règle rigide, comme ne noter que les échecs, réduit fortement le bénéfice de la mémoire : le gain recule de 0,234 point pour Opus 5. À l’inverse, un modèle plus ancien comme Sonnet 4.6 profite de consignes précises : invité à lire sa mémoire avant de répondre et à tester explicitement ses hypothèses, il passe à 0,641.
Le « rêve », pour corriger ses souvenirs
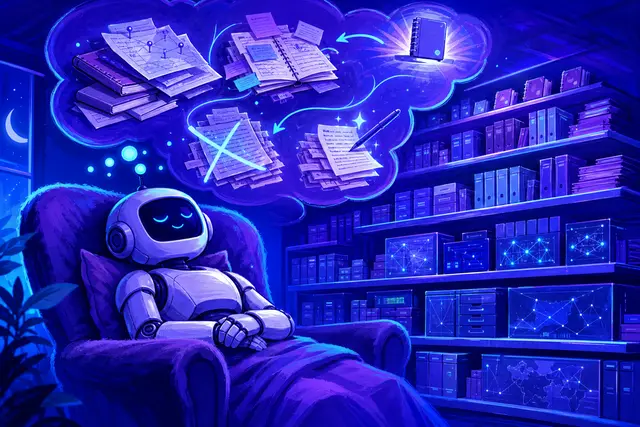
L’idée la plus marquante de l’étude est la phase dite de « rêve » (dreaming). Comme le cerveau pendant le sommeil, l’agent profite des périodes sans activité pour relire ses historiques, vérifier ses notes face à ce qui s’est réellement passé, corriger les erreurs, construire des wikis et décider quelles notes méritent d’être chargées à chaque session.
Anthropic en donne un exemple concret. Dans Pokémon, une note fausse plaçait un centre de soins du mauvais côté d’une grotte. L’agent, persuadé d’avoir terminé l’étape, est tombé trois fois du même rebord et n’a jamais atteint la ville suivante. Après une phase de rêve qui a corrigé la note à partir des historiques, il l’a atteinte en 1 935 actions.
Des wikis pour s’orienter dans de gros volumes
Anthropic a aussi testé des wikis construits par Claude à partir de documents internes d’une entreprise, environ 350 000 fichiers. En multipliant les sessions de rêve de deux à 128, la part des critères satisfaits sur 25 questions de test est passée de 13 % à 48 % avec le wiki seul. Combiné à une recherche classique dans les documents, le wiki atteint 61 %, contre 53 % pour la recherche seule, tout en économisant environ 20 000 unités de texte par question.
Sur des dossiers juridiques de fusion d’entreprises, le wiki fait passer le taux de réussite de 73 % à 87 % pour les questions qui mobilisent plusieurs documents. Il n’apporte en revanche aucun gain net quand l’information se trouve dans un seul document. Dans un cas, le wiki produit était même 1,77 fois plus volumineux que les documents d’origine.
Les limites reconnues
L’étude ne présente pas la mémoire comme une solution miracle. Anthropic liste plusieurs difficultés :
- une note peut être fausse dès le départ ou devenir obsolète, et continuer d’être utilisée ;
- entretenir la mémoire coûte du temps et de la puissance de calcul, la phase de rêve comprise ;
- prendre des notes pendant la tâche détourne l’attention de l’agent ;
- charger une note ne garantit pas que l’agent la respecte, et des consignes trop longues sont moins bien suivies ;
- les wikis peuvent grossir au-delà des sources et accumuler des erreurs.
La plupart des expériences reposent par ailleurs sur une seule exécution, sans mesure de variabilité, et sur des tests conçus par Anthropic. Les résultats indiquent des tendances plus qu’ils ne fournissent des garanties.
Les conseils pratiques pour les développeurs
Pour ceux qui conçoivent des agents d’IA, l’étude dégage plusieurs recommandations concrètes :
- expliquer à quoi sert la mémoire plutôt que dicter comment l’utiliser, et laisser les modèles récents juger de ce qui mérite d’être retenu ;
- pour les modèles plus anciens, demander explicitement de relire la mémoire avant d’agir ;
- garder très court ce qui est chargé à chaque session ;
- s’appuyer d’abord sur une recherche dans les historiques, et n’ajouter un wiki que si les questions croisent plusieurs documents ;
- quand plusieurs agents travaillent ensemble, leur confier des pages séparées plutôt qu’un tableau partagé, où des informations se perdent.
Ces mécanismes sont accessibles aux développeurs à travers Claude Managed Agents, le service d’agents hébergés d’Anthropic, qui propose un dossier de mémoire et une documentation dédiée au rêve. L’étude ne précise ni le tarif, ni le statut de disponibilité de cette fonction.
Vers des agents qui apprennent au fil du travail
La mémoire est devenue un terrain de concurrence entre les laboratoires : Meta en avait fait l’argument de son modèle Muse Wonder, présenté en octobre 2026. L’étude d’Anthropic montre que la question dépasse la capacité de stockage : il s’agit de savoir quoi retenir, comment vérifier ce qui a été retenu et comment l’organiser. Anthropic reconnaît que des questions restent ouvertes, notamment sur le moment où créer une note et la façon de la tenir à jour. Pour les entreprises, l’enjeu est concret : un agent qui apprend vraiment de ses erreurs devient plus fiable à chaque tâche, à condition que ses souvenirs soient régulièrement contrôlés.
Questions fréquentes
Qu’est-ce que la mémoire d’un agent d’IA ?
Selon la définition d’Anthropic, c’est l’ensemble des connaissances qu’un agent tire de son expérience et conserve d’une session à l’autre, sous forme de texte qu’il peut relire. Cela comprend les historiques de sessions, les notes prises pendant les tâches, des wikis et un petit ensemble de notes chargé à chaque démarrage.
Que signifie le « rêve » d’un agent d’IA ?
Le « rêve », ou dreaming, est une phase pendant laquelle l’agent, hors activité, relit ses historiques pour vérifier et corriger ses notes, construire des wikis et choisir les informations à charger à chaque session. Anthropic s’inspire de la consolidation de la mémoire humaine pendant le sommeil.
La mémoire améliore-t-elle vraiment les performances de Claude ?
Sur le test CL-Bench d’Anthropic, oui pour les modèles récents : Claude Opus 5.5 passe de 0,655 à 0,838 et Opus 5 de 0,564 à 0,828. Le gain est faible pour l’ancien Sonnet 4.6, sauf avec des consignes précises. Ces résultats proviennent de tests conçus par Anthropic.
Comment bien configurer la mémoire d’un agent ?
Anthropic conseille d’expliquer à quoi sert la mémoire plutôt que d’imposer des règles rigides, de garder très court ce qui est chargé à chaque session, de vérifier régulièrement les notes à partir des historiques et, pour les modèles anciens, de demander de relire la mémoire avant d’agir.
Sources
Références consultées pour la rédaction de cet article. Les adresses sont indiquées à titre informatif et ne sont pas des liens.
- Anthropic, The components of agent memory, 6 novembre 2026www.anthropic.com/research/components-of-agent-memory